

En una pintura de Antoine Watteau aparece un músico vestido para una representación teatral. La obra se titula Mezzetin y pertenece a la colección del Metropolitan Museum of Art de Nueva York. Al seleccionarla en una pantalla, aparece una recomendación inesperada: Léon Pallière in His Room at the Villa Medici, Rome, de Jean Alaux.
La segunda pintura representa una habitación en Roma. Hay libros, dibujos, esculturas y una guitarra. Las composiciones son distintas, pero ambas obras comparten una etiqueta en el catálogo del museo: Guitarras.
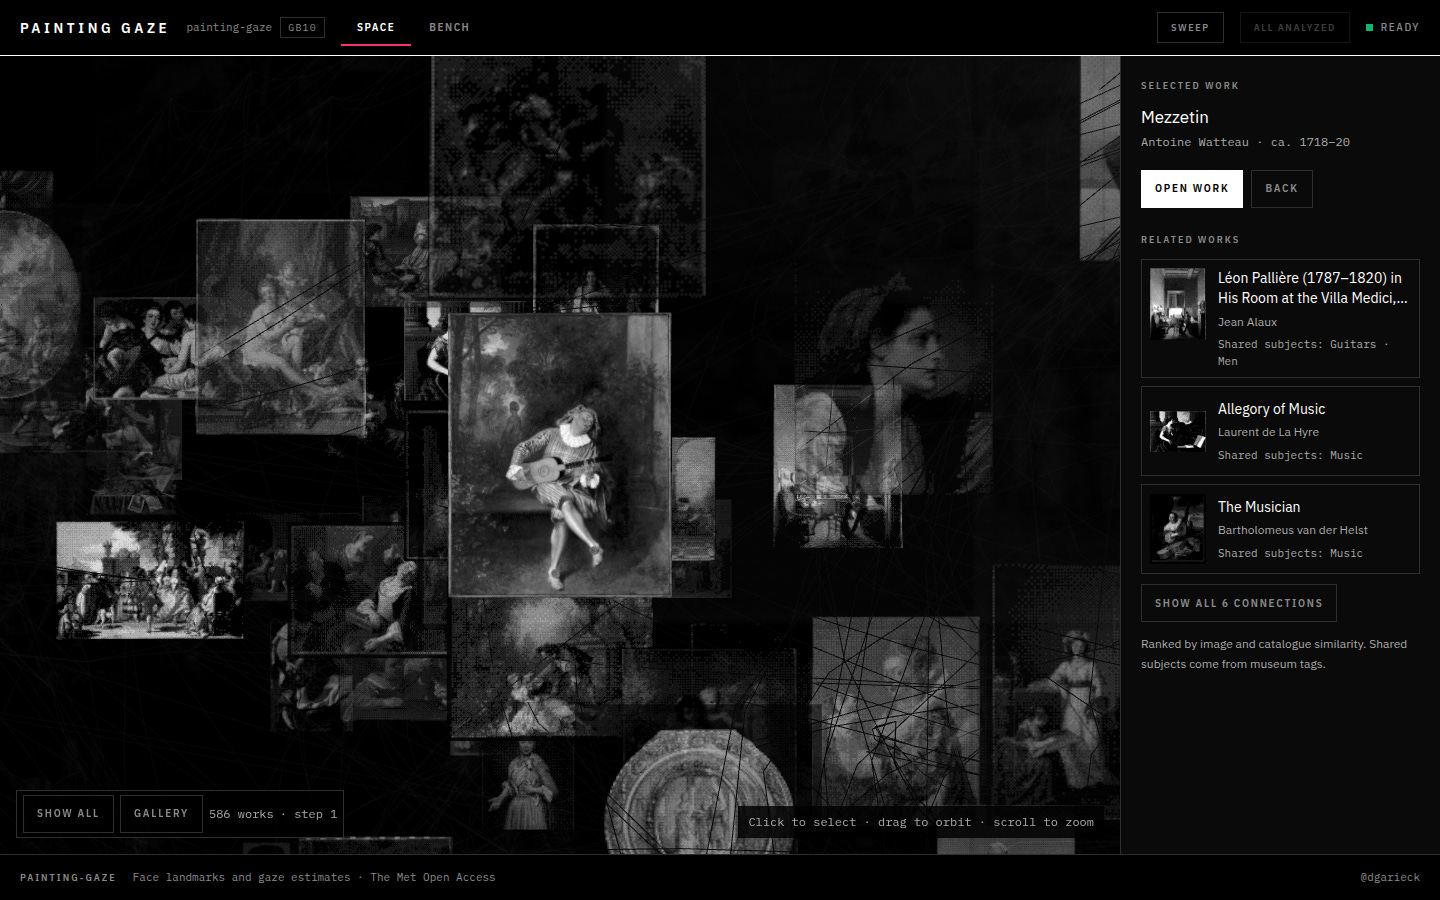
Esa conexión permite iniciar un recorrido entre obras que difícilmente encontraríamos navegando únicamente por artista, época o movimiento artístico. Desde allí, podemos continuar hacia Allegory of Music, The Musician y otras piezas relacionadas, siguiendo las asociaciones recuperadas por un modelo multimodal.
Es una de las experiencias que construí en Painting Gaze, un prototipo de exploración artística desarrollado con 586 obras de la colección Open Access del Met.
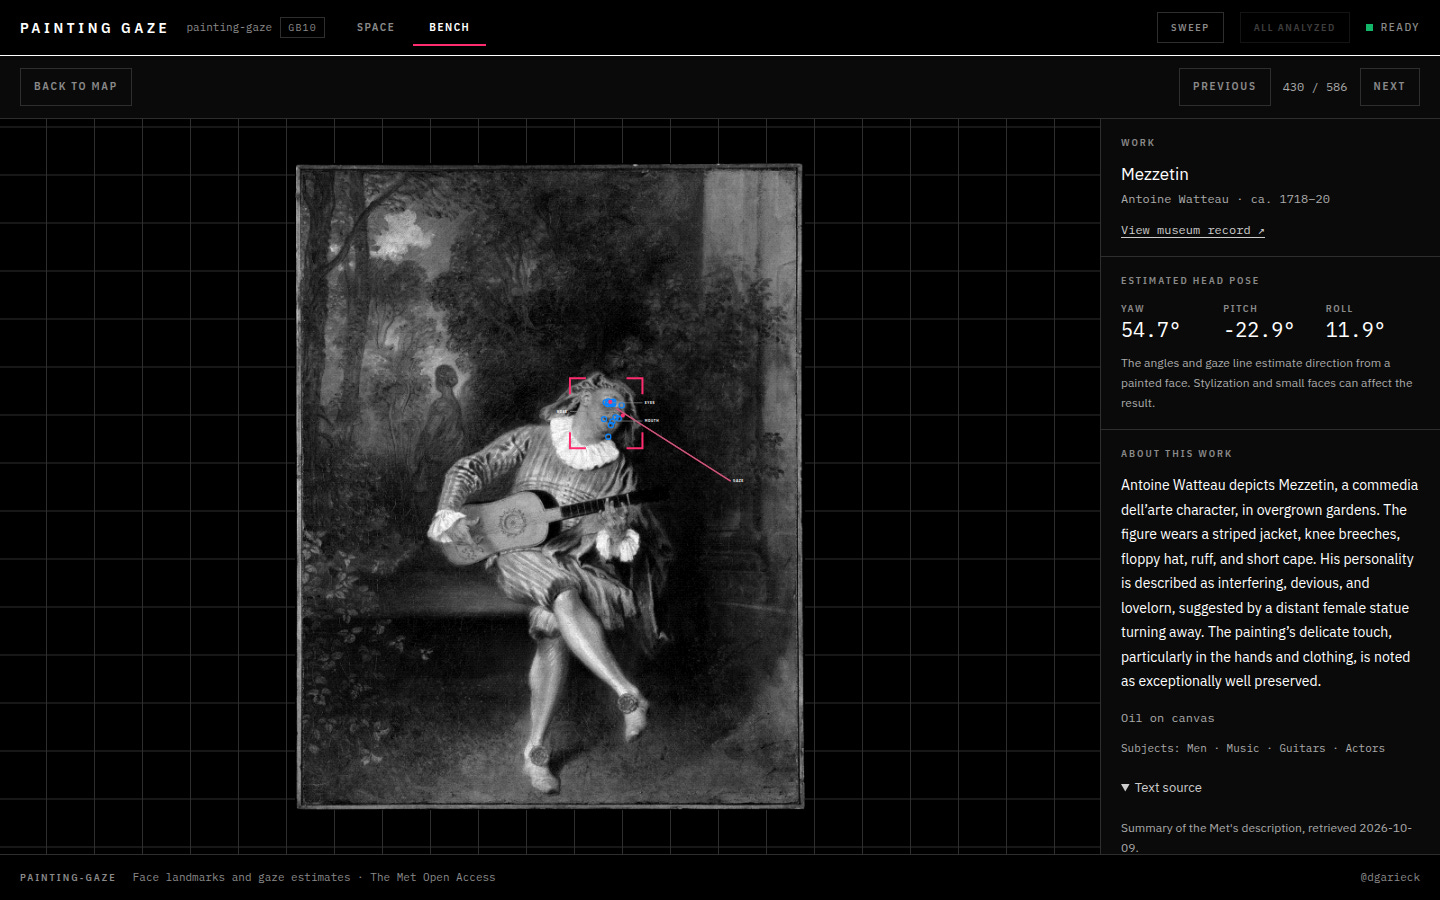
La aplicación organiza las obras en un mapa interactivo. Podemos comenzar por retratos, música o escenas de madres con niños, seleccionar una pintura y descubrir otras relacionadas. Al abrir una obra, encontramos información del museo y, en determinados casos, un análisis de los rostros representados: posición de los ojos, puntos faciales, orientación de la cabeza y una estimación de la dirección de la mirada.
Las 586 obras distribuidas en un espacio tridimensional que permite seleccionar pinturas y explorar sus conexiones.
Me interesaba construir una experiencia que permitiera recorrer una colección siguiendo afinidades visuales y semánticas. Las fichas del museo proporcionan el contexto histórico, mientras que los modelos de machine learning proponen nuevas conexiones que el visitante puede explorar.
Hay una diferencia importante entre encontrar una conexión e interpretarla. En el ejemplo de Watteau y Alaux, la guitarra constituye una coincidencia documentada entre ambas obras. Sin embargo, no podemos afirmar que esa característica sea la única que explica la proximidad calculada por el modelo.
Construir esta experiencia también permitió investigar problemas de representación multimodal, recuperación aproximada, compresión vectorial y visión computacional.
Uno de los resultados fue especialmente interesante: pude reducir 76,8 veces el tamaño de los vectores utilizados para recuperar candidatos y conservar el 99,52 % de coincidencia con los vecinos exactos del top-10 después de aplicar reranking.
Para entender cómo llegué a ese resultado, conviene comenzar por la información que recibe el modelo.
Metodología
Representar una obra más allá de sus píxeles
Una fotografía de una pintura no contiene toda la información disponible sobre ella. El título, la atribución, el periodo, los materiales y los temas documentados aportan contexto que puede modificar las relaciones que recupera un modelo.
Para construir los embeddings utilicé EmbeddingGemma 2, proporcionando la imagen RGB original junto con información estructurada del catálogo en una entrada multimodal intercalada. El modelo procesa ambas modalidades conjuntamente, en lugar de combinar posteriormente embeddings visuales y textuales calculados por separado.
Los registros incluyen título, artista, fecha, técnica, tipo de objeto, cultura, nacionalidad, periodo y etiquetas temáticas. También incorporé descripciones breves cuando las páginas oficiales del museo ofrecían información suficiente.
De los 586 registros, 542 pudieron enriquecerse con textos documentados. Utilicé un servicio local de Qwen para elaborar los resúmenes a partir de esas fuentes, acompañado de controles sobre fechas, fragmentos recuperados y afirmaciones sin respaldo. Las 44 obras restantes conservaron sus metadatos originales.
Este proceso también exigió respetar las atribuciones del catálogo. Lady Guildford, por ejemplo, aparece como «Copy after Hans Holbein the Younger», sin fecha especificada. Eliminar esa calificación modificaría la información que el visitante consulta y que el modelo utiliza para construir su representación.
Al finalizar, cada obra quedó representada por un embedding normalizado de 768 dimensiones.
Comprimir sin perder el recorrido
Quería investigar cuánto podía reducir esa representación antes de alterar significativamente las relaciones entre obras.
Utilicé Matryoshka Representation Learning (MRL) para trabajar con las primeras 256 dimensiones del embedding, normalizadas nuevamente, y TurboQuant para comprimirlas utilizando un bit por coordenada.
El resultado fue una reducción de aproximadamente el 98,7 % en el espacio ocupado por estos vectores.
Sin embargo, la compresión también afectó la recuperación.
Evalué las relaciones haciendo que cada una de las 586 obras consultara las otras 585, tomando como referencia la búsqueda exacta con los embeddings completos de 768 dimensiones.
La configuración más comprimida conservaba menos del 70 % de coincidencia con los conjuntos de vecinos originales.
La siguiente prueba consistió en cambiar la forma en que utilizábamos esa representación.
En lugar de producir directamente el ranking final, el índice HNSW cuantizado de Qdrant recupera 80 candidatos. Posteriormente, una segunda representación con los vectores originales permite calcular las puntuaciones completas de 768 dimensiones y seleccionar las seis obras relacionadas.
Con este procedimiento, la coincidencia del top-10 aumentó al 99,52 % para MRL con TurboQuant de un bit.
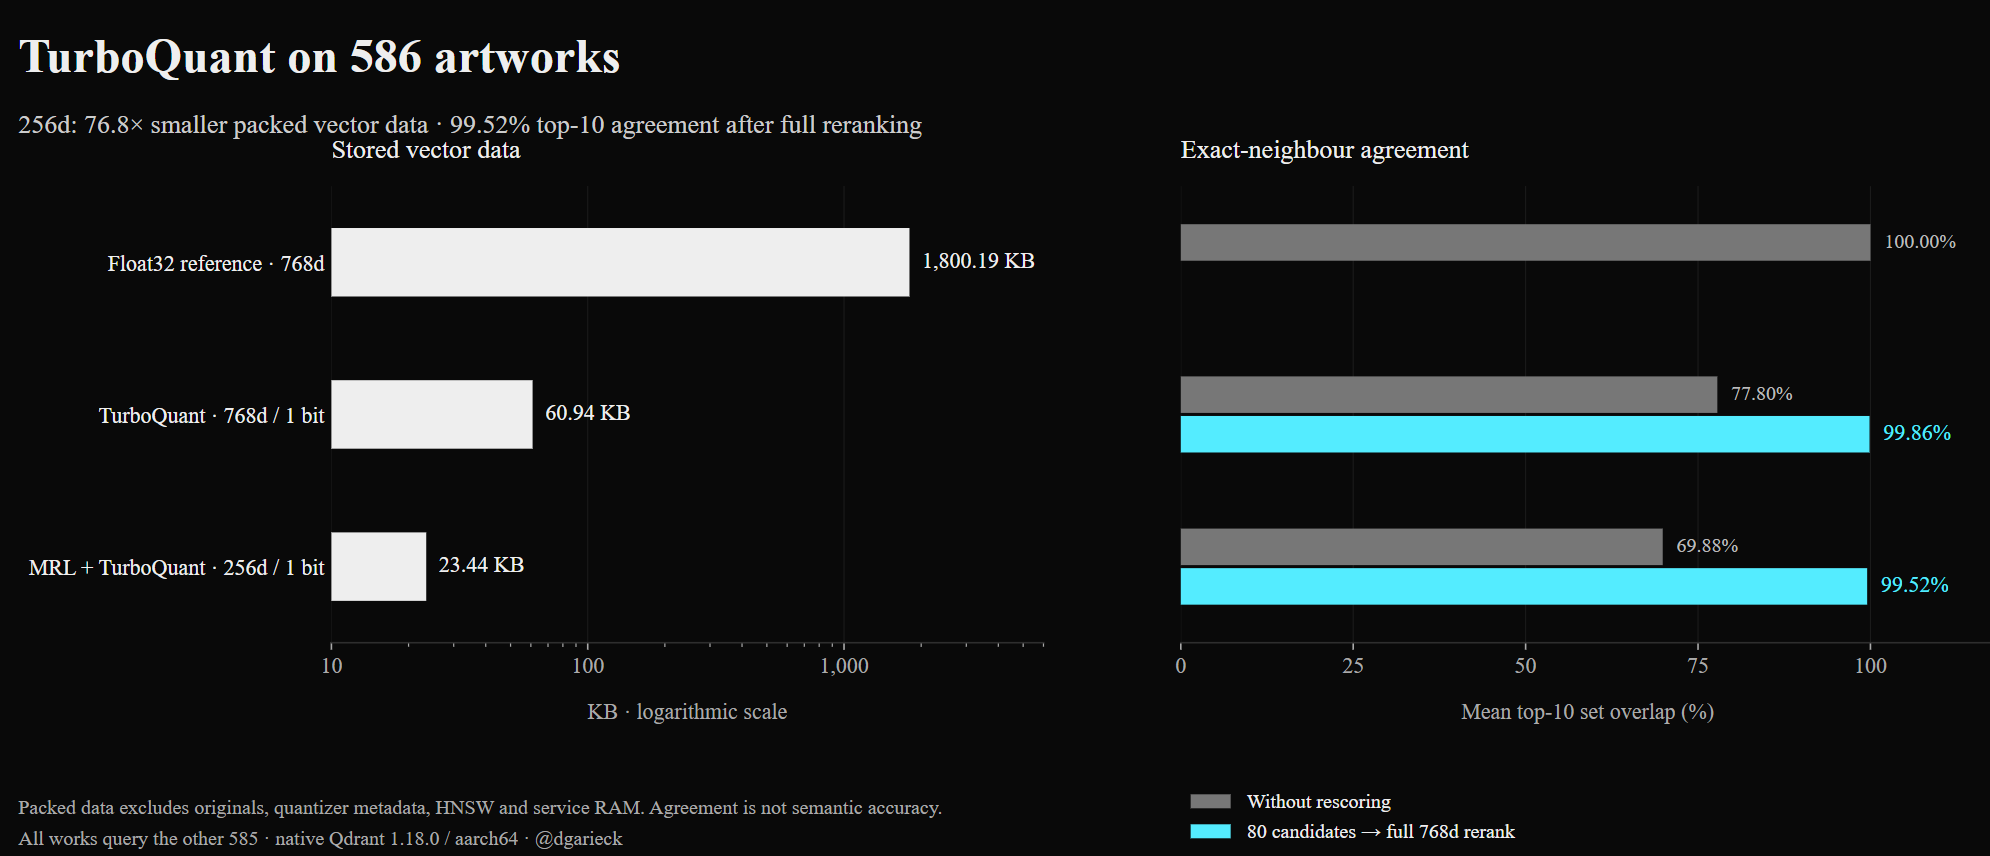
En el grafo que utiliza la aplicación se preservaron 3.513 de las 3.516 conexiones dirigidas de la referencia exacta, equivalentes al 99,91 %.
La representación comprimida resulta suficiente para localizar casi todos los candidatos necesarios en esta colección. El reranking conserva acceso a los vectores completos, por lo que el ahorro en datos cuantizados no elimina el coste de mantener los originales.
También es importante delimitar el resultado: estamos midiendo coincidencia con una búsqueda vectorial exacta. La relevancia artística de las recomendaciones requeriría otra evaluación, con juicios independientes de las distancias calculadas por el modelo.
El mapa tridimensional y sus propias distorsiones
Para representar visualmente la colección utilicé UMAP, proyectando los embeddings originales en tres dimensiones.
Esta reducción permite convertir cientos de vectores en un espacio navegable, aunque modifica las relaciones de proximidad.
En las pruebas, la proyección conservó únicamente el 54,57 % de los conjuntos originales de los 15 vecinos más cercanos.
Por eso utilizo UMAP para posicionar las obras en el mapa, mientras que sus conexiones proceden de la recuperación vectorial y el reranking. La proximidad visual entre dos imágenes puede diferir de sus relaciones semánticas en el espacio original.
La interfaz utiliza imágenes monocromáticas organizadas en seis niveles tonales, pero EmbeddingGemma procesa siempre las imágenes originales en color. También conserva las proporciones de cada obra y carga imágenes de mayor resolución al seleccionarlas.
¿Hacia dónde miran los personajes de una pintura?
El otro componente experimental utiliza computer vision para analizar los rostros representados en las obras.
La línea de mirada visible combina la orientación de la cabeza con una heurística basada en el desplazamiento de las pupilas.
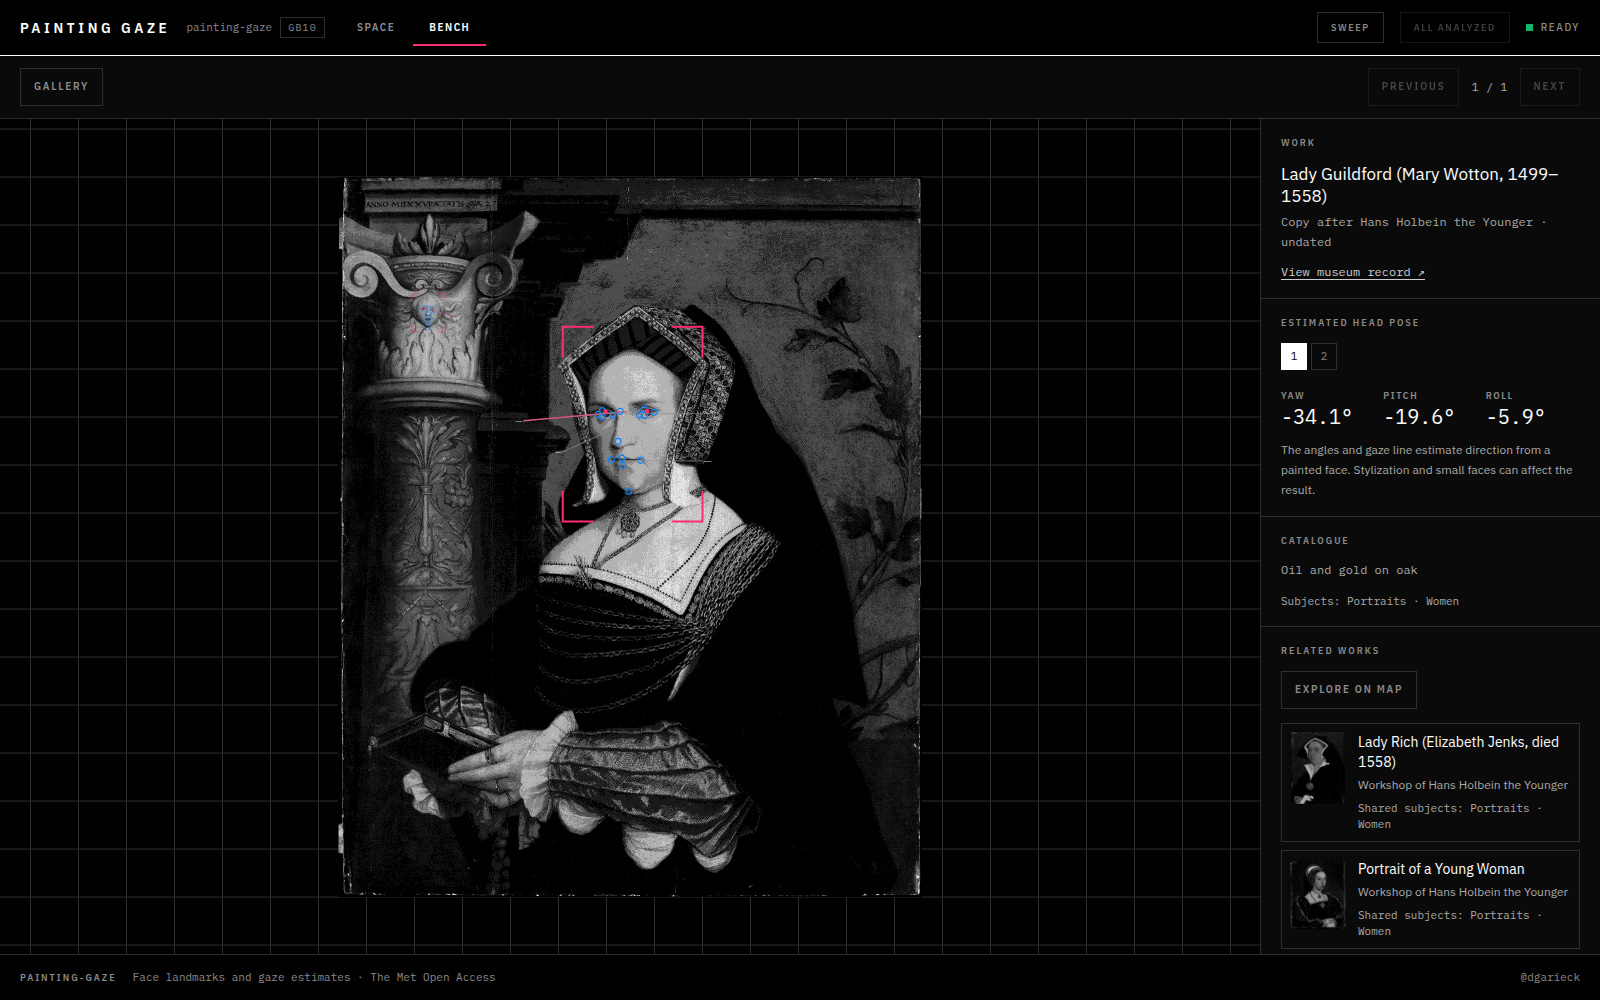
El sistema registró 1.652 detecciones en 573 de las 586 obras, una cobertura del 97,78 %. Sin embargo, los rostros estilizados, los perfiles, las figuras pequeñas y los elementos decorativos pueden producir resultados incorrectos.
La cobertura describe cuántas obras contienen detecciones. No mide precisión ni recall, y tampoco garantiza que todas correspondan a rostros humanos.
Las trece obras sin detecciones permanecen disponibles para inspección. La aplicación también presenta los ángulos y las líneas de mirada como estimaciones, con información adicional del procesamiento para quien quiera revisar los resultados.
Nuevas formas de experimentar un museo
El prototipo permite explorar una colección digital, pero me interesa especialmente lo que podríamos construir al trasladar estas interfaces a espacios culturales físicos.
Una primera posibilidad es incorporar instalaciones interactivas en museos y galerías. Una pantalla podría permitir a los visitantes seleccionar una obra de la sala y explorar relaciones con piezas que se encuentran en otras salas, depósitos o colecciones. De esta manera, el recorrido físico podría complementarse con uno semántico.
Las exposiciones temporales ofrecen otro contexto. Sus recorridos suelen responder a una selección curatorial definida, pero una interfaz de exploración permitiría descubrir conexiones adicionales entre las obras sin alterar la narrativa principal de la exposición.
También sería interesante experimentar con proyecciones de gran formato o superficies interactivas donde los visitantes puedan explorar composiciones, observar relaciones temáticas e inspeccionar estimaciones geométricas de los personajes representados.
Estas aplicaciones todavía requieren validación. El prototipo demuestra que podemos integrar recuperación multimodal, contexto documental y análisis visual en una experiencia navegable. Sin embargo, no hemos medido su efecto sobre la atención, el aprendizaje o la satisfacción de los visitantes.
Ese sería el siguiente paso.
Podríamos comparar recorridos tradicionales con experiencias de exploración multimodal, observar qué obras despiertan interés, qué conexiones se consideran relevantes y si los visitantes descubren piezas que normalmente habrían ignorado.
También necesitaríamos incorporar el criterio curatorial. Un score vectorial puede proponer asociaciones útiles, pero no determina por sí mismo su significado histórico o artístico.