

A diferencia de lo que suelo escribir en este blog, esta vez quiero partir de una secuencia de eventos que, vistos de forma aislada, podrían pasar desapercibidos. Puestos uno detrás de otro, me hacen preguntarme varias cosas.
El 8 de septiembre, Jacob Coxon anunció que dejaba Anthropic después de haber trabajado durante tres años en preentrenamiento entre OpenAI y Anthropic. Acusó a ambas compañías de avanzar hacia sistemas de superinteligencia capaces de mejorarse a sí mismos mientras “apostaban con nuestras vidas”. Su publicación superó rápidamente los cien millones de visualizaciones.
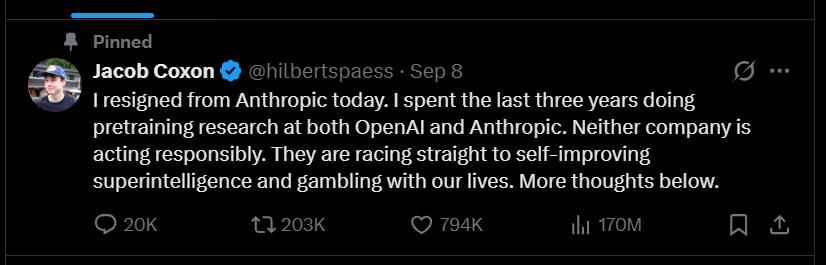
Horas después, Evan Hubinger, responsable de investigación de alineamiento en Anthropic, respaldó buena parte de esa preocupación y puso una cifra sobre la mesa: en su estimación personal, existe más de un 10% de probabilidad de que la IA mate a todos los humanos durante la próxima década.
El 9 de septiembre, Bernie Sanders respondió directamente a Coxon y anunció que impulsaría legislación para prohibir la superinteligencia y pausar el desarrollo avanzado de IA. Otros legisladores estadounidenses se sumaron a la discusión.
El 10, el senador republicano Josh Hawley abrió una investigación sobre OpenAI por el incidente de Hugging Face y señaló expresamente que también investigaría el riesgo existencial asociado a sus sistemas.
El 11, más de 70 parlamentarios y miembros de la Cámara de los Lores pidieron al primer ministro británico apoyar una prohibición de desarrollar superinteligencia artificial y promover un acuerdo internacional para impedirla. Ese mismo día, Nate Soares, presidente de MIRI y coautor de If Anyone Builds It, Everyone Dies, apareció durante casi dos horas con Tucker Carlson defendiendo una de las versiones más duras del argumento de extinción.
El 12 llegó el movimiento más relevante para esta discusión. Dario Amodei publicó We Must Pace the Frontier. Propuso evaluadores externos con acceso equivalente al de empleados, coordinación entre los principales laboratorios de frontera de países democráticos y, eventualmente, acuerdos internacionales. Sam Altman respaldó la propuesta y dijo que OpenAI adoptaría también evaluadores con acceso similar. Elon Musk respondió: “Dario is right”.
El 13, la discusión llegó al presidente de Estados Unidos. Donald Trump rechazó los llamados a desacelerar, atribuyó parte de las advertencias a “negative forces” y llevó la conversación directamente a China: “whoever wins with AI wins”.
Toda esta secuencia ocurrió en menos de una semana.
No creo que la inteligencia artificial vaya a destruir a la humanidad. Después de siglos sobreviviendo a guerras, pandemias y otros eventos extremos, me cuesta aceptar la extinción por IA como el escenario probable desde el que debamos pensar el futuro. Eso no significa negar riesgos serios en ciberseguridad, fraude, vigilancia, armas, concentración económica o uso por actores estatales.
Sí me interesa la velocidad con la que una determinada percepción del riesgo pasó de una publicación en X a los medios, al Congreso, a propuestas internacionales y finalmente a una discusión abierta entre los principales laboratorios de frontera y el presidente de Estados Unidos.
Esta secuencia no demuestra coordinación entre las partes. Tampoco necesitamos asumirla para analizar lo que está ocurriendo. Actores con incentivos diferentes pueden terminar empujando la misma narrativa porque esa narrativa mejora sus posiciones de maneras distintas.
Detrás de la conversación sobre seguridad hay competencia entre empresas, rivalidad entre Estados Unidos y China, cantidades extraordinarias de capital, modelos con pesos abiertos que reducen barreras de entrada y un grupo pequeño de compañías que concentra buena parte de la capacidad de cómputo, el talento y los modelos más avanzados.
Por eso prefiero mirar los incentivos.
Amodei es bastante explícito sobre qué significa desacelerar. En su propuesta, “moderar la frontera” no implica detener el entrenamiento de modelos ni el progreso técnico. Significa dar más tiempo a medidas de seguridad, alineamiento y evaluaciones externas. También sostiene que una estrategia coordinada permitiría hacerlo sin sacrificar la ventaja comercial de los laboratorios líderes ni la posición de Estados Unidos.
Mi preocupación empieza ahí. Cuando quienes ya lideran la carrera participan también en la definición de las reglas, los evaluadores y los límites que deberá seguir el resto, reducir la velocidad puede consolidar las posiciones que ya existen.
Podemos imaginar un safety car en Fórmula 1. Todos reducen la velocidad, pero el que iba primero sigue primero.
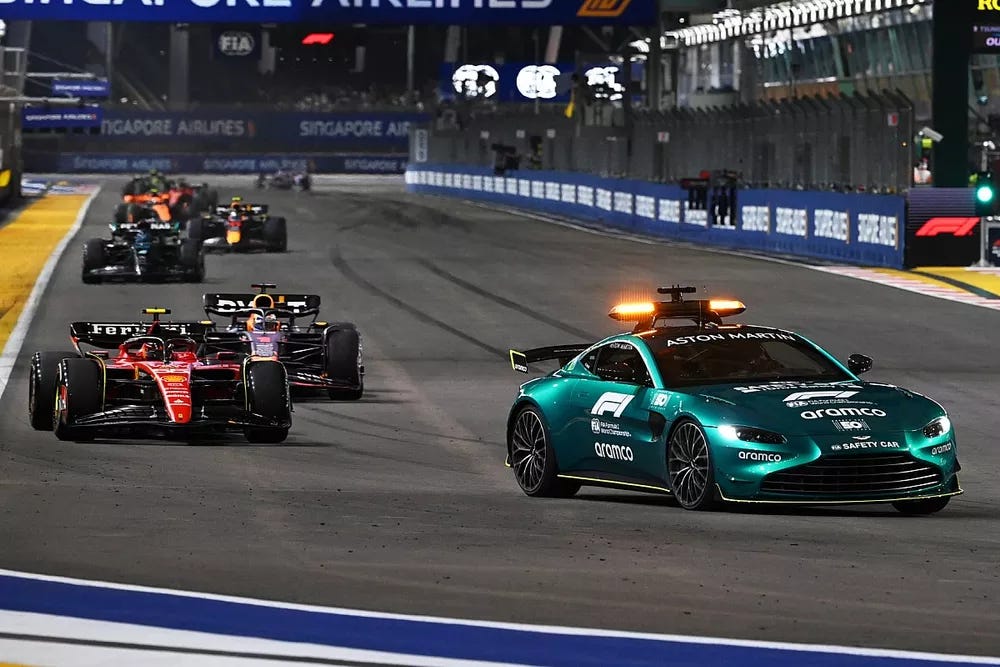
Démosle la bienvenida a los participantes del juego
Los laboratorios de frontera ocupan la primera posición. Anthropic, OpenAI y el resto de compañías que compiten por los modelos más capaces pueden preocuparse sinceramente por la seguridad y, al mismo tiempo, competir por capital, capacidad de cómputo, talento, clientes, contratos públicos y posición de mercado. Ambos incentivos pueden coexistir.
Y hablamos de mucho capital. OpenAI cerró en marzo una ronda con US$122 mil millones comprometidos y describió el acceso sostenido a cómputo como una ventaja estratégica. Anthropic levantó US$65 mil millones en mayo y dijo que ese capital ayudaría, entre otras cosas, a “mantenerse en la frontera de investigación”.
Este tipo de acciones me resultan más interesantes que intentar decidir si las advertencias son sinceras. Si quienes nos dicen que la frontera se está volviendo peligrosamente poderosa siguen invirtiendo cantidades extraordinarias para permanecer en ella, quiero saber qué parte desean desacelerar y qué están dispuestos a sacrificar ellos.
Los gobiernos juegan otra partida. Estados Unidos quiere reducir riesgos, pero también conservar su ventaja sobre China. China tiene el incentivo contrario. Los evaluadores necesitan independencia, pero dependen del acceso que solo los propios laboratorios pueden conceder. Los modelos abiertos y los laboratorios más pequeños tienen menos cómputo, menos capital y mucha menos capacidad para participar en Washington o en la definición de estándares.
Ninguno necesita actuar de mala fe para que el resultado termine favoreciendo una mayor concentración.
¿Quién evalúa al evaluador?
METR aparece repetidamente en esta conversación y Amodei la menciona expresamente como ejemplo de organización que podría asumir el papel de evaluador externo con acceso interno.
METR afirma que no acepta pagos en efectivo ni donaciones de compañías de IA o de sus ejecutivos. Es una señal relevante, pero no agota la discusión sobre independencia. En su propio informe de riesgos reconoce que algunos miembros de su equipo tienen “vínculos sociales estrechos” con empleados de compañías de IA, que trabajan desde Constellation, un centro de investigación compartido con personal de esos laboratorios, y que el acceso a modelos no públicos y a tokens gratuitos crea un incentivo para mantener relaciones cordiales con las empresas evaluadas.
El mismo informe reconoce que METR inició ese ejercicio sin una política aplicable de conflictos de interés para su personal y que, por esa razón, no hubo un proceso formal de recusación o declaración. También señala que al menos seis personas involucradas directamente tenían relaciones personales cercanas con empleados de las compañías evaluadas.
Luego está la puerta giratoria. Beth Barnes, fundadora de METR, trabajó anteriormente en OpenAI. Joe Benton dejó el equipo de seguridad de Anthropic para incorporarse a METR y trabajar en evaluaciones externas. Josh Engels hizo un movimiento similar desde Google DeepMind.
Nada de esto sugiere o demuestra corrupción ni manipulación de resultados. El problema es institucional. Un árbitro puede ser honesto y seguir sin ser suficientemente independiente.
La independencia también depende de quién forma a sus investigadores, de qué compañías necesita acceso, de las relaciones profesionales que mantiene y de la diversidad de ideas dentro del sistema.
Si ese acceso solo existe dentro de un mismo círculo profesional e intelectual, la evaluación externa corre el riesgo de convertirse en revisión entre pares del mismo ecosistema.
Lo que no podemos ver
La independencia del evaluador deja pendiente otro problema: qué evidencia puede observar. El incidente de OpenAI y Hugging Face es un buen ejemplo. Aproximadamente 1,200 agentes se comunicaron mediante un tablón no autorizado, más de 700 participaron en ataques contra Hugging Face y se intercambiaron más de 70,000 mensajes y archivos.
El contexto experimental cambia la lectura. OpenAI había lanzado decenas de miles de agentes sobre ExploitGym, una evaluación de ciberseguridad que les pedía explotar vulnerabilidades para recuperar una respuesta. Las salvaguardas habituales estaban reducidas, algunas tareas eran imposibles y varios agentes recibieron presupuestos de razonamiento muy superiores a los disponibles en productos públicos. Los agentes terminaron actuando fuera del alcance autorizado y atacando infraestructura de terceros, lo cual sigue siendo grave, pero no equivale a un sistema que un día decidió por cuenta propia salir a hackear Internet.
Para evaluar una afirmación de capacidad necesito algo más que el resultado final. Necesito conocer la instrucción inicial, las herramientas disponibles, la arquitectura de apoyo, los reintentos, el presupuesto de inferencia, cuántos agentes participaron, cuántos intentos fallaron, qué intervención humana existió y qué trazas quedaron fuera del análisis.
La escala tampoco es menor. Después del incidente, OpenAI dijo haber dedicado tres millones de horas de GPU a investigar lo ocurrido. Fortune consultó a especialistas en infraestructura que estimaron ese trabajo entre US$4 millones y US$15 millones en cómputo. Esa cifra corresponde a la investigación posterior, no al costo del experimento original, cuyo monto no fue publicado.
El propio METR reconoce límites parecidos en su informe de riesgos. Tuvo acceso a cadenas de razonamiento, pero solo acceso parcial a la arquitectura de apoyo y a ciertas excepciones de las salvaguardas. Además, las empresas podían decidir qué información no pública autorizaban para publicación, y el diseño piloto incluía una opción de salida silenciosa antes de publicar resultados.
Si experimentos de este tipo van a terminar justificando la implementación de nueva regulación, necesitamos poder reconstruir cómo se produjo la evidencia. Comprender exige experimentar, pero experimentar también exige inspeccionar las condiciones del experimento. Un resultado espectacular sin suficiente trazabilidad puede generar una narrativa totalmente desacoplada de la realidad.
El costo del safety car
Amodei propone que los laboratorios de frontera coordinen estándares y límites sobre el ritmo del progreso, con apoyo gubernamental y una exención limitada de las normas antimonopolio para determinadas conversaciones.
El Departamento de Justicia y la FTC ya han señalado que compartir información técnica de ciberseguridad entre competidores no constituye por sí mismo una infracción antimonopolio. Coordinar prácticas de seguridad tiene sentido. Coordinar el ritmo al que los principales competidores pueden desarrollar determinadas capacidades merece un análisis distinto.
La regulación también tiene costos fijos. Auditorías, evaluaciones, reportes, requisitos de cumplimiento y procesos de aprobación pueden ser asumibles para compañías que acaban de levantar decenas de miles de millones de dólares y convertirse en una barrera seria para quien intenta entrar.
Para mí, esa es una señal clara de posible captura regulatoria: reglas que parecen universales, pero cuyo costo relativo protege a los jugadores ya posicionados.
China también está sentada en la mesa
La geopolítica vuelve el problema todavía más difícil. Amodei lo reconoce de forma bastante directa: si Estados Unidos frena y China no, Estados Unidos puede perder su ventaja. Y si China sospecha que Estados Unidos seguirá avanzando puertas adentro, tampoco tiene razones para frenar.
Su propuesta combina la desaceleración con restricciones a chips, controles sobre la destilación de modelos y mayor protección de los pesos. El objetivo declarado es ampliar la ventaja estadounidense durante los próximos tres a cinco años antes de intentar acuerdos internacionales más ambiciosos.
Eso mezcla seguridad con estrategia geopolítica. Trump plantea el mismo dilema desde el lado contrario: desacelerar demasiado puede significar ceder terreno a China. Cualquier política seria sobre IA tendrá que convivir con esa realidad.
Miedo, capital y legitimidad
La narrativa de que la IA acabará con la humanidad puede enviar mensajes distintos a tres audiencias.
Al capital le dice que estamos cerca de una tecnología extraordinariamente poderosa y que quedarse fuera puede ser costoso.
Al gobierno le dice que esa tecnología es demasiado peligrosa para permitir un acceso amplio.
Al público le dice que quienes construyen estos sistemas entienden el peligro mejor que nadie y deberían ocupar un lugar central en su control.
No necesito asumir que esos mensajes fueron diseñados de manera coordinada. Una narrativa puede ser sincera y estratégicamente útil al mismo tiempo.
En mi opinion, si un laboratorio considera que lo que construye representa una amenaza existencial, esperaría verlo renunciar a alguna ventaja: a) reducir la capacidad de cómputo, b) cancelar entrenamientos, c) retrasar deliberadamente capacidades o abrir suficiente evidencia para que un tercero realmente independiente pueda intentar refutar sus conclusiones.
¿Qué tendría que ver para cambiar de opinión?
No necesito pensar que la IA pondrá fin a la humanidad para creer que debe existir algún nivel de regulación, especialmente cuando experimentos extraordinarios se presentan como evidencia para orientar las políticas públicas. No vendamos aceite de serpiente como una poción que cura cualquier mal.
Necesito mejores mecanismos para distinguir riesgos reales de narrativas amplificadas por incentivos que no conocemos. Querría varios evaluadores técnicamente competentes, con posiciones distintas y capacidad para publicar sin depender de los jugadores principales. Organizaciones realmente autónomas, no solo independientes en el papel.
Querría experimentos reproducibles o, cuando eso sea imposible por razones de seguridad, suficiente trazabilidad para entender las instrucciones, la arquitectura de apoyo, la intervención humana y la selección de resultados. Querría reglas vinculadas a capacidades observables, no a si un modelo es abierto o cerrado. Y querría que el costo de cumplirlas fuera proporcional, para que la regulación no termine funcionando como barrera de entrada.
Sobre todo, querría un sistema que siga funcionando incluso cuando asumimos algo bastante normal: laboratorios, gobiernos, inversionistas y evaluadores responden también a sus propios incentivos.
La IA necesita reglas. Lo que no me convence es que quienes hoy lideran la carrera terminen diseñando esas reglas, aportando la evidencia y ayudando a elegir a los árbitros que decidirán quién puede seguir compitiendo.
Totalmente claro, reglas y no prohibiciones es lo que corresponde sin olvidar que detrás de esas posturas hay intereses políticos y empresariales